贝叶斯分类(Chap.4)
同样直接看 CS229 即可, 这里也是分类问题。按照下面的逻辑来,有些地方是不需要细看的。
-
引入概念: discriminative learning algorithm VS generative learning algorithm:
DLA 就是之前的回归预测,GLA 就是要学的内容。给定一个动物的特征,让你判断是大象还是小狗:
- DLA 在样例中寻找一条直线,左边是大象,右边是小狗;即直接就是给我一个数据,我就直接判断是哪个类别。
- GLA 很反直觉,他是反过来的,他回答/学习的是假设我是大象,那么得到的这个样例的概率是多少;再假设是小狗,观察到这个样例的概率是多少。最后再通过贝叶斯反推,各个类别的概率是多少。

-
引入概念: Gaussion discriminative analysis (GDA),就是上面的图片,用高斯来计算概率:
GDA 是上面 GLA 的一种实现;而 Logistic Regression 是 DLA 的最常见实现,GDA 和 Logistic 的比较: 4.1.3 讲了这个。
- 事实上,如果把 GDA 转换,会发现它就是符合 logistical 的公式样子。这里可以不用太纠结。
-
他们的区别: GDA 一定是 logistical,但是 logistical 不一定是 GDA
- 如果 p(x|y) 是 Gaussion,那么 p(y|x) 最后也是符合 logistical,也可以使用 GDA
- 但是 p(x|y) 是 其他分布,比如泊松,那么 p(y|x) 符合 logistical,但不能用 GDA
-
然后是 Navie Bayes,它是什么:
同样以一个例子来说。现在要进行垃圾邮件分类,这里面的
x = [0, 1, 0, 1 ...],假设有 10000 个单词。如果按照 GDA 算法,那么这个 x 有 2^10000 种可能性,导致参数过多。基本可以认为 GDA 和 Naive Bayes 是并列关系:它们都是基于贝叶斯公式的生成式分类方法。但是 GDA 把 x 假设为多元高斯分布,然后求分布的参数;而 Naive Bayes 把 x 假设为独立分布,然后求分布的参数。
-
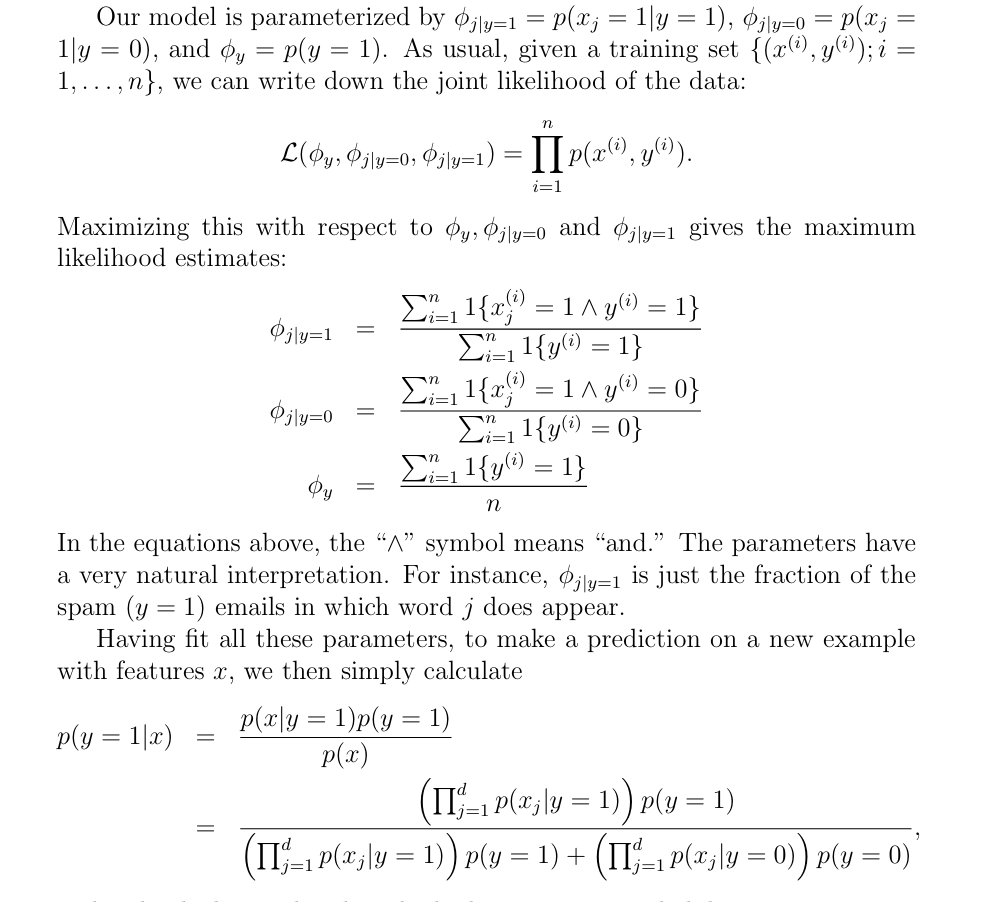
Navie Bayes 具体公式
- 直接看 Page.44 中的结果即可。图片:
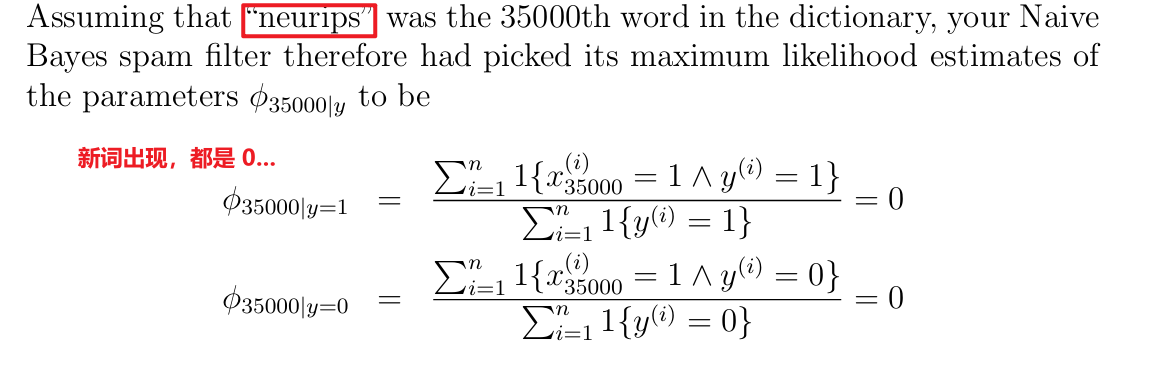
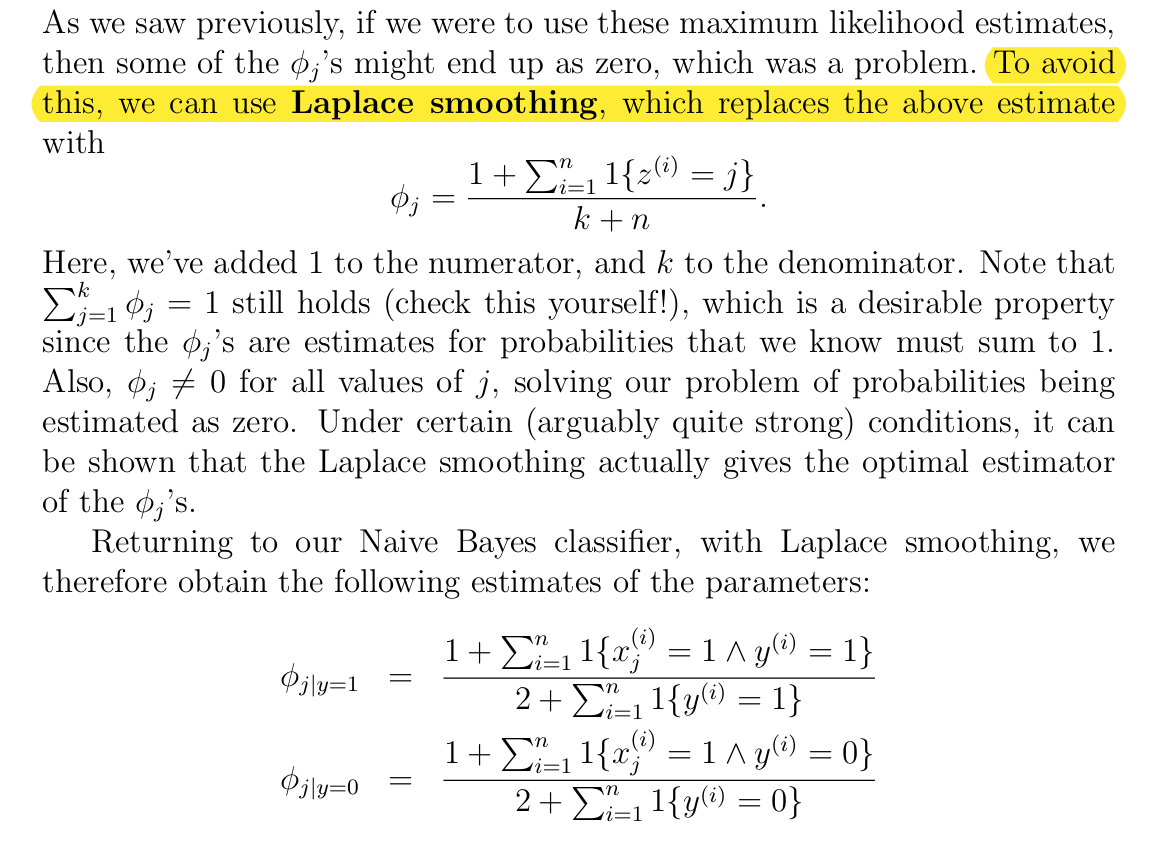
- 拉普拉斯平滑,4.2.1 介绍。原因:有新词出现会有 0/0 情况;解决:多加一个保险项。
-
Multinomial event model,可以看 4.2.2 节。贝叶斯的方法叫做 Bernoulli Event Model。区别就是 Bernoulli 只考虑只考虑单词是否出现(0/1),Multinomial 模型考虑出现次数,具体改变的公式看文档。